之前用Codex有一点非常烦,就是给它安排一些预期执行时间很长的任务,它总是干一会儿就提前停下来
比如做「视觉风格图鉴」,让它根据要求生成140多种风格的示例图
| 要求 | 我的理解 |
|---|---|
| 完成全部 146 种风格 | 目标明确 |
| 每张图片采用相同的生成流程 | 规则明确 |
| 每完成一张就更新 Markdown 进度表 | 进度持久化 |
| 读取进度表即可找到下一个任务 | 可恢复 |
| 大部分图片可以按照既定规则处理 | 不需要频繁决策 |
预期应该是无需人工干预的,但Codex总是在做完几张图后就停下来和我汇报进度,即使多次在提示词里重复强调,明确指示“不要停,也不用汇报,直到生成所有的示例图”,它还是会停下来……
得频繁地回一句“继续”才能推进,用户体验非常糟糕,但又无可奈何
Github上也有不少issue报告这个问题
- GitHub Issue #13950:一位开发者要求 Codex 协调完成 200 个子 Agent 相关任务,同时最多运行 5 个。但在很多次执行中,Codex 只完成大约 10/200 就提前停止,输出进度报告
- GitHub Issue #36596:另一位开发者描述了更让人困惑的情况:Codex 知道整个项目仍然有待完成的工作,知道下一步可以做什么,也知道不需要用户提供额外输入。用户已经明确要求不要在提交代码、测试或中间阶段之后停下来。但 Codex 仍然反复输出最终回答。
很长一段时间,因为这个问题我都觉得Codex不够聪明。
针对这个问题,Codex推出了工程上的解决方案——Goal
Codex的Goal #
OpenAI在2026年5月发布的一篇Using Goals in Codex,介绍了Goal,并直观对比了 Prompt 和 Goal 在工作机制上的差异
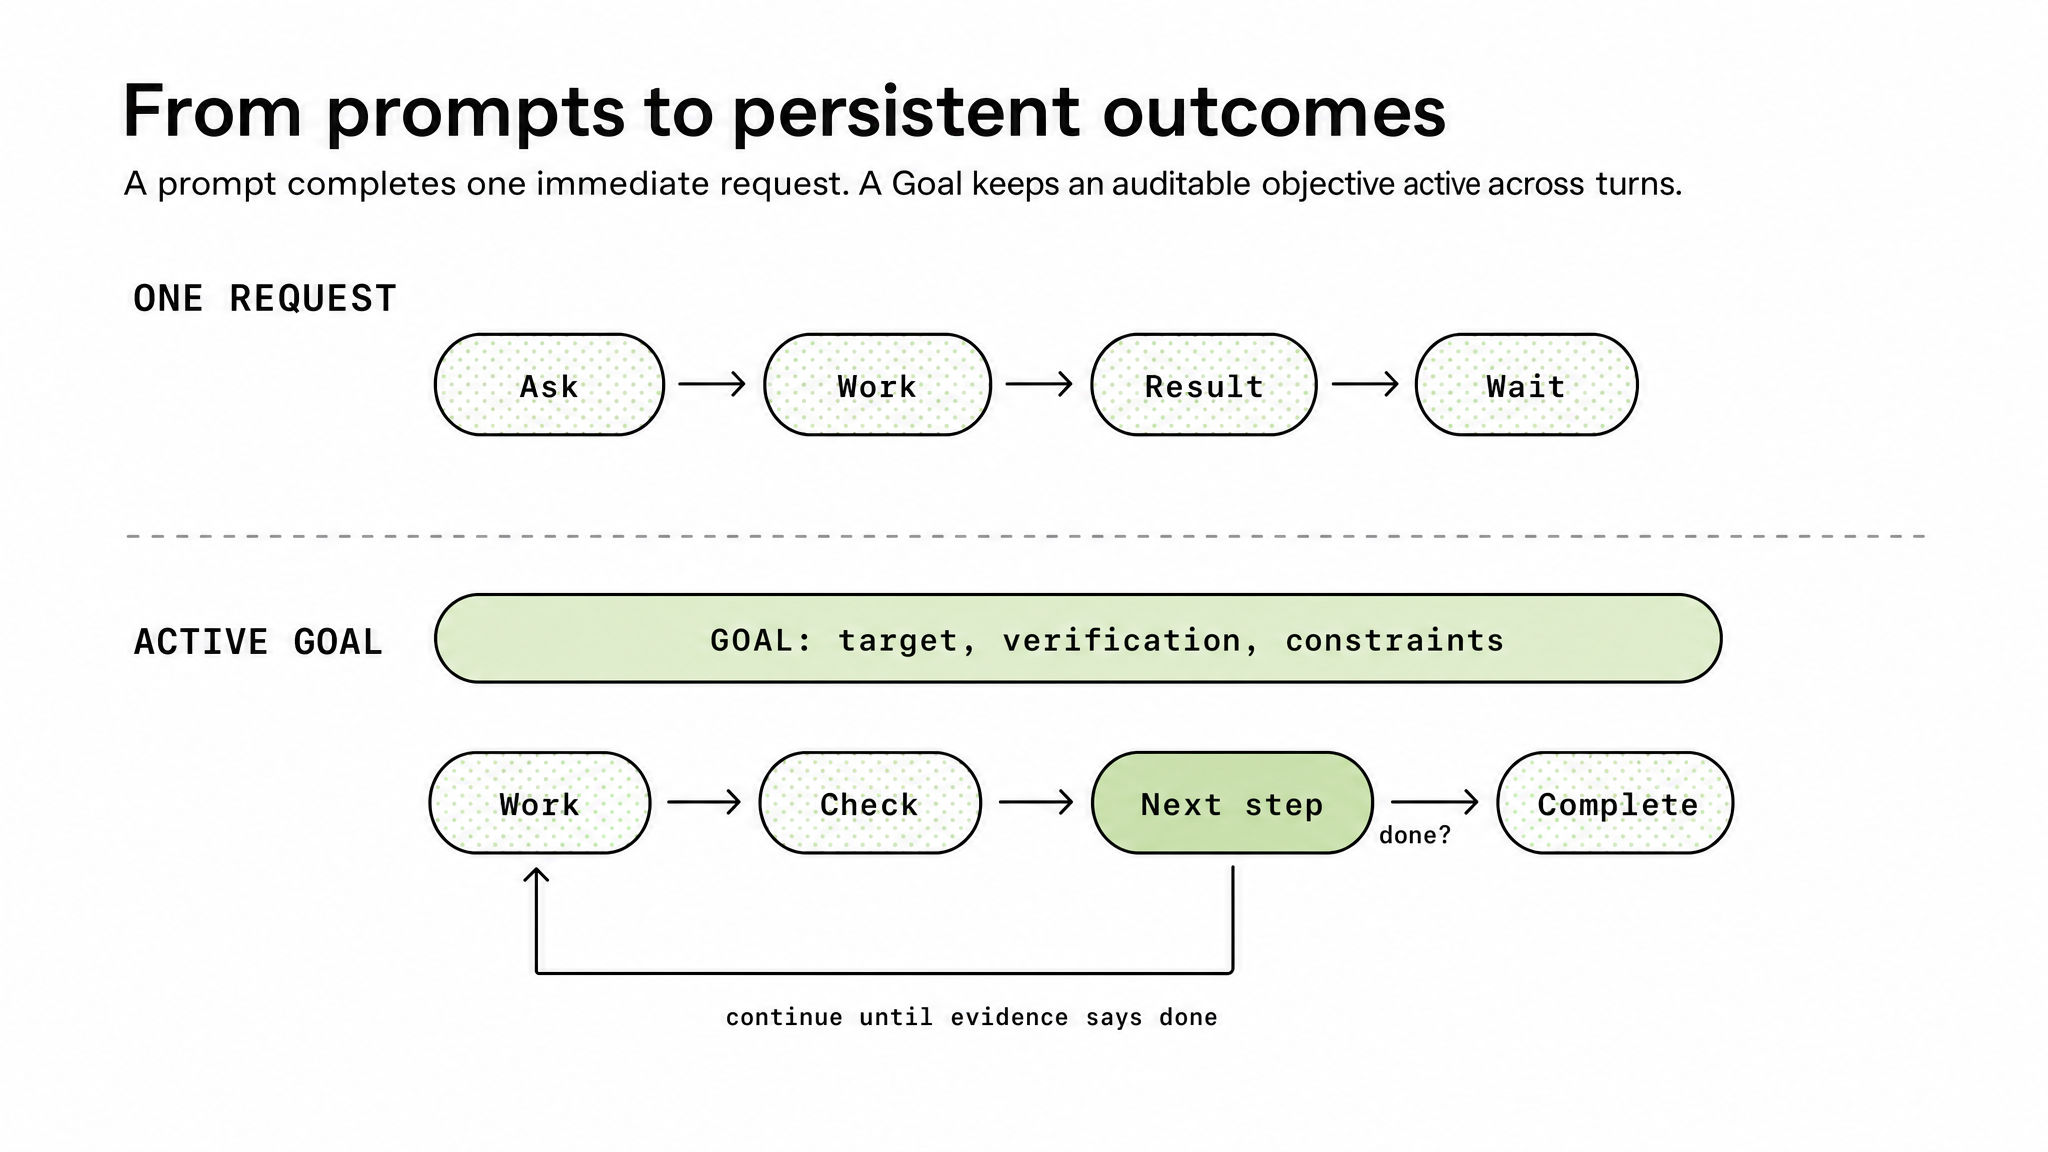
Prompt在处理完当前的一次对话,就会停下来,等待用户的下一条指令,而Goal则会持续盯着一个设定好的目标,直到有证据可以证明任务已完成
大概流程如下
flowchart TD
    A["用户设置 /goal"] --> B["Goal Runtime"]
    B --> C["创建并持久化 Thread Goal"]
    C --> D["启动 Turn 1"]

    subgraph REACT["Turn 内部:ReAct 循环"]
        direction TB
        D --> E["模型 Reasoning"]
        E --> F{"选择下一步"}
        F -->|"Tool Call"| G["执行工具"]
        G --> H["Observation"]
        H --> E
        F -->|"Final Answer"| I["当前 Turn 结束"]
    end

    I --> J["Goal Dispatcher"]
    J --> K{"Goal 仍 Active
且允许续跑?"}
    K -->|"否"| L["结束自动续跑 / 等待"]
    K -->|"是"| M["生成 Continuation Prompt"]
    M --> N["start_turn_if_idle"]
    N --> O["启动下一个 Turn"]
    O --> E

    classDef goal fill:#DBEAFE,stroke:#60A5FA,color:#1E40AF
    classDef agent fill:#D1FAE5,stroke:#34D399,color:#065F46
    classDef decision fill:#FEF3C7,stroke:#FBBF24,color:#92400E
    classDef stop fill:#FEE2E2,stroke:#F87171,color:#991B1B

    class A,B,C,D,J,M,N,O goal
    class E,G,H agent
    class F,K decision
    class I,L stop
简单来说
- Prompt模式,本质上就是一轮ReAct循环:大模型根据用户的Prompt和上下文进行推理Reasoning,决定下一步的Acting,是到此为止?还是执行工具?若执行工具,待拿到工具结果后,再继续推理Reasoning,如此循环
- 而Goal模式,则是在ReAct循环的基础上套了一层续跑控制:当内层ReAct循环结束后,续跑控制层再对Goal的完成状态进行检查,决定是否续跑
最近优化「视觉风格图鉴」时用上了Goal,相见恨晚!在这个项目里,除了触发限额外就再也没有停下来过了。
「长任务总是提前结束」这个恼火的问题总算得到解决(就是感觉比以往费Token)
但我也开始好奇一个问题,在ReAct循环里,“为什么大模型明明知道任务还没完成,却仍然会选择提前结束?”
大模型处理长任务的难点 #
目前并没有找到公开的研究可以解释大模型这个现象背后的根本原因,倒是发现了不少实验探索,在以不同的角度研究这个问题,涉及到大模型的训练阶段、执行阶段、终止阶段
训练阶段:为什么任务步骤越多,模型越难训练? #
论文 On Training Large Language Models for Long-Horizon Tasks 的研究者探索这么一个问题:假如决策规则完全一样,只增加成功所需的行动次数,模型会不会明显变差?
他们通过构造像数独这种不同长度,但遵循相同决策规则的受控任务进行实验
- 任务A:完成一次数独填数操作
- 任务B:连续完成几十次数独填数操作,直到整盘解出数独
然后发现:仅增加任务跨度就足以引起训练的不稳定。而这种不稳定是由 「exploration difficulties」 和「credit assignment challenges」导致的
exploration difficulties 路径探索难题
假设每一步有两个选择,正确和错误。
那么连续三步全部猜对的概率是:(1/2)³ = 12.5%,
而连续十步全部猜对的概率就剩下:(1/2)¹⁰ ≈ 0.098%。
随着决策步骤的增加,全部走对的轨迹极度稀缺,模型很难获得有效的正面反馈
credit assignment challenges 信用分配挑战
假设任务进行到了20步然后失败,是哪一步开始导致的失败?
是第3步错了?还是第12步错了?
仅有一个失败结果,很难对轨迹上的每个步骤进行归因,即便有负面数据也很难利用起来
所以,当任务跨度变长后,模型训练要获得有效反馈的难度显著上升
执行阶段:长任务会在哪些环节失败? #
论文 The Long-Horizon Task Mirage? Diagnosing Where and Why Agentic Systems Break 探索的问题是,当Agent执行很长的任务时,究竟是在哪个环节开始出错的?
研究者设计了一个诊断框架,在四类环境中评估 GPT-5 系列和 Claude-4 系列模型,收集超过 3,100 条执行轨迹:
- Web:网页操作
- OS:操作系统任务
- Embodied:具身操作,例如机器人任务
- Database:数据库任务
随后对失败轨迹进行分析,并将观察到的问题归纳为下面7类
| 失败类别 | 失败类型 | 通俗解释 |
|---|---|---|
| Agent执行过程 | Environment Error | 没有正确感知工具或环境变化 |
| Agent执行过程 | Instruction Error | 理解或执行指令有偏差 |
| Agent执行过程 | Planning Error | 规划或下一步行动错误 |
| Agent执行过程 | History Error Accumulation | 早期错误影响后续行动 |
| Agent自身设计 | False Assumption | 未验证就作出错误假设 |
| Agent自身设计 | Catastrophic Forgetting | 先前约束仍在上下文中,却不再被有效使用 |
| Agent自身设计 | Memory Limitation | 关键信息因上下文或记忆限制而不可用 |
其中过程类问题占72.5%,设计类问题占27.5%。而且,随着任务跨度增加,规划错误(Planning Error)、灾难性遗忘(Catastrophic Forgetting)和记忆限制(Memory Limitation)问题更加突出。
原来一开始我所以为的「不聪明」,有这么复杂的成因,比如当Codex处理到第5张图后停了下来,此时
- 它还能复述原来的任务吗? 会不会出现了记忆限制或灾难性遗忘
- 它知道目前实际的进度吗? 会不会环境感知出了偏差,又或者累积了历史错误
- 它有没有错误地以为任务已经完成? 会不会出现了错误假设
- 它是否知道下一步应该做什么? 会不会在指令理解或行动规划上发生了错误
终止阶段:Agent 能判断何时继续、何时停下吗? #
前面都在关注,不应该结束的任务却提前结束,反过来想,对于应该早点结束的任务,Agent是否能正确停止呢?比如
- 用户的目标存在矛盾。
- 当前工具无法完成目标。
- 执行到一半才发现关键条件不成立。
- 继续操作可能造成不可逆的错误
- ……
这个论文 AgentAbstain: Do LLM Agents Know When Not to Act? 就在探索这个问题,研究者构建了263 组任务,覆盖 42 个可执行环境和 17 个前沿模型,最后发现:最佳模型在“应继续行动”与“应当停止”的成对任务中,同时判断正确的比例也只有 59.5%
或许,现阶段对于存在明确完成标准、且错误代价较高的任务,不应只依赖大模型的自主判断,还应配备外部验证机制
还是「长任务提前结束」这个问题
关于如何进行外部验证,论文 When May an Agent Stop? Evidence-Carrying Termination for Tool-Using LLMs 提出了 Evidence-Carrying Termination携带证据的终止机制,简称ECT
在这个机制下,ECT判断任务的完成需要结合三个部分
flowchart TD
    A["任务要求 Requirements"] --> D["确定性验证器"]
    B["工具执行证据 Ledger"] --> D
    C["完成证书 Certificate"] --> D
    D --> E{"证据是否覆盖全部要求?"}
    E -->|是| F["允许 COMPLETE"]
    E -->|否| G["拒绝完成 / CONTINUE"]
    G --> H["Agent 补齐证据或恢复执行"]
- 任务要求。哪些结果必须存在
- 工具执行证据。工具调用的执行状态和结果等
- 完成证明。任务声明完成的时候要有与之匹配的证据
在实验中,研究者设计了48个合成任务,为每个任务注入了八类故障:
- 无必要证据却声明完成
- 引用其他对象的证据
- 工具表面成功、内部实际出错
- 数据范围或日期不匹配
- 遗漏必要结果
- 最终计算值被篡改
- 引用不存在的证据
- 重复调用但存在恢复办法
最后实验结果:没有采用ECT时,无依据的提前终止比例高达60.6%,而在用了ECT之后提前终止比例降到0%。
实验条件比较理想,不代表现实的成功率,但在大模型外部加入更严格的终止验证,确实能显著减少没有充分证据支撑的“提前完成”
这一点也从Codex的Goal使用体验中得到印证
小结 #
- 大模型处理长任务会提前停下来是一个普遍现象
- 目前还没有公开研究解释大模型这个现象背后的根本原因
- 大模型的训练、执行、终止判断,都面临诸多问题和挑战
- 仅靠提示词无法解决这个问题
- 对完成标准明确的长任务,Codex的Goal是一个实用的工程解法